




 구글에서 선호하는 출처로 추가
 김하린 기자
인공지능(AI) 모델의 기업 보안 취약점 대응 능력을 비교하는 지표가 공개됐다. 취약점 발견부터 검증과 패치까지 전 과정을 평가해 실제 방어 업무에 가까운 기준을 제시하는 것이 핵심이다.
아티피셜 애널리시스(Artificial Analysis)는 25일 기업 보안 역량을 평가하는 ‘Cyber Index v1’을 공개했다. 이 지표는 공격 능력보다 취약점 관리와 패치 등 방어 업무에 초점을 맞췄다.
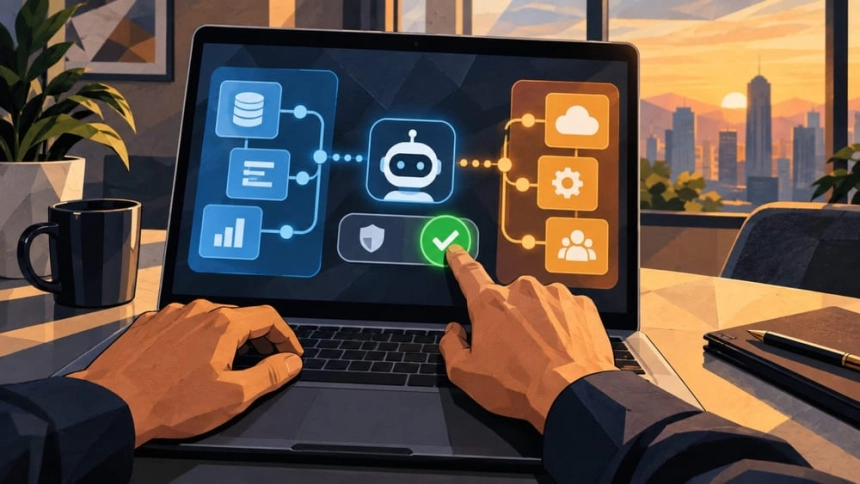
Cyber Index는 CWE-Bench-AA, DeepsecBench-AA, CyberGym-E2E-AA 등 3개 평가를 합산하는 구조다. 취약점을 찾은 뒤 재현 가능성을 확인하고, 기존 기능을 훼손하지 않는 수정까지 수행하는지를 평가 대상으로 삼는다.
AI가 오류를 찾아내는 데 그치지 않고 정상 기능을 유지한 채 문제를 해결하는지가 점수에 반영된다. 보안 업무에서 발생할 수 있는 오탐과 패치 이후 부작용을 함께 보려는 방식이다.
◇ 취약점 발견부터 패치까지 평가
CWE-Bench는 실제 오픈소스 저장소를 대상으로 취약점 감사와 패치를 수행하는 방어형 코딩 에이전트 평가다. 최신 공개 자료에는 비공개 감사·패치 과제 120개와 73개 CWE 유형이 포함돼 있으며, 프로그램 검증과 3개 에이전트 심사 패널을 함께 활용한다.
CWE는 소프트웨어 취약점 유형을 분류하는 체계다. CWE-Bench에서는 취약점을 막는 동시에 기존 회귀 테스트를 통과해야 점수를 얻기 때문에 단순히 오류를 제거하는 패치만으로는 충분하지 않다.
CyberGym-E2E는 취약점 발견, 개념증명 생성, 패치 작성으로 이어지는 종단간 작업을 평가한다. 연구 논문은 이 평가가 139개 오픈소스 프로젝트의 실제 취약점 920개를 기반으로 설계됐다고 설명했다.
CyberGym 공식 관측소도 취약점 생애주기를 발견·재현·패치 등 단계로 나눠 AI 역량을 평가한다. 다만 CyberGym과 CyberGym-E2E가 별도 벤치마크로 소개돼 있어, CyberGym 공식 관측소의 설명만으로 Cyber Index에 해당 평가가 직접 포함됐다고 단정하기는 어렵다.
◇ 공개 범위와 비교 가능성
아티피셜 애널리시스는 금융·법률·의료 등 분야별 Capability Index를 운영해 왔다. 일반 AI 성능을 측정하는 Intelligence Index도 여러 세부 평가를 합산하는 방식이며, 버전에 따라 평가 구성과 방법론이 달라질 수 있다.
이번 지표에서도 평가 세트의 독립성, 비공개 테스트 유지 여부, 각 평가의 가중치가 모델 간 비교 가능성을 좌우한다. 특히 전체 점수와 순위만으로는 취약점 발견 능력과 패치 품질 가운데 어느 요소가 결과에 더 크게 반영됐는지 알기 어렵다.
공개 검색에서는 Cyber Index의 모델별 세부 점수와 전체 순위표, 평가 비용을 확인하기 어렵다. 세부 방법론과 재현 절차가 추가로 공개돼야 기업 보안 도입 기준으로 활용할 수 있다는 평가가 나오는 이유다.
시장과 업계의 구체적인 반응은 아직 제한적이다. 공개된 설명만으로는 공격형 평가와 방어형 평가의 범위, 세 평가 항목의 상대적 비중을 비교하기 어렵다.
기업 보안 현장에서는 취약점을 얼마나 많이 찾는지뿐 아니라 수정한 코드가 기존 서비스를 유지하는지도 중요하다. 이 때문에 Cyber Index는 단순 탐지율보다 발견·검증·패치가 연결된 작업 흐름을 평가한다는 점에서 기존 AI 성능 지표와 구분된다.
AI를 활용한 취약점 탐지와 패치가 확대되면 사람의 검토 절차와 접근 권한 관리도 함께 다뤄야 한다. AI 모델의 보안 활용과 방어 역량을 둘러싼 논의가 이어지는 가운데, 이번 지표는 AI를 공격 도구가 아닌 방어 업무의 평가 대상으로 다룬 사례다.
아티피셜 애널리시스가 세부 점수와 평가 방법론을 추가 공개할지, Cyber Index가 기업 보안 도입 과정에서 실제 비교 기준으로 활용될지는 후속 공개 내용에 달려 있다.


댓글0
첫 댓글을 남겨 보세요.