




 구글에서 선호하는 출처로 추가
 최윤서 기자
일론 머스크가 이끄는 xAI가 Colossus 2에 엔비디아($NVDA) GB300 GPU 66만개를 연말까지 배치한다는 보도가 나왔다. 다만 해당 수치는 공식 확정치로 확인되지 않았으며, 전력·냉각 인프라 확보가 실제 가동 규모를 좌우할 변수로 남아 있다.
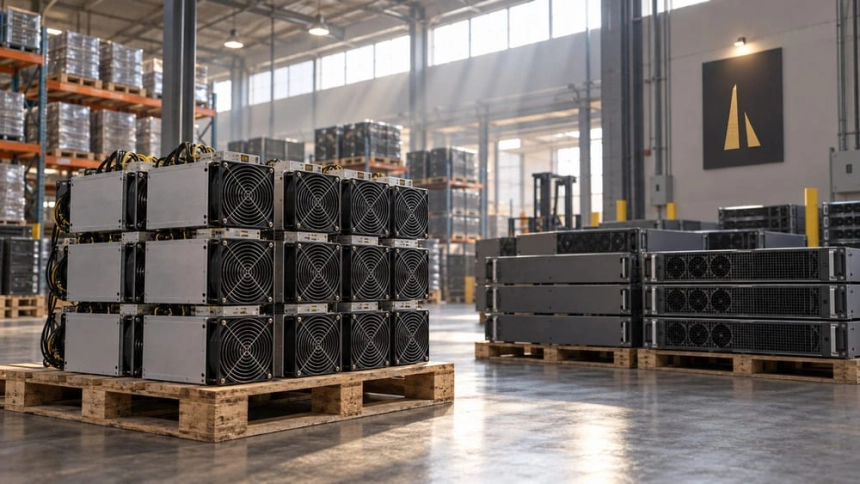
크립토브리핑은 머스크가 12월 말까지 Colossus 2에 GB300 GPU 66만개를 탑재하려 한다고 보도했다. xAI 공식 자료에는 2026년까지 멤피스 시설에 GPU 100만개를 갖추겠다는 계획이 제시됐지만, GB300 66만개라는 세부 수치는 공개되지 않았다.
외부 분석기관 Epoch AI는 9월 24일 업데이트에서 Colossus 2에 엔비디아 B200 약 11만개와 B300 약 33만개 등 총 44만개의 GPU가 설치된 것으로 추정했다. 추정 연산능력은 H100 환산 111만2000개, IT 전력 사용량은 946MW, 자본비용은 358억달러(약 49조원)다.
Epoch AI는 추가 확장이 완료되면 2027년 1분기 B300 61만2200개와 B200 11만개 등 총 72만2200개의 GPU가 가동될 것으로 전망했다. 이때 연산능력은 H100 환산 약 182만5000개, IT 전력 사용량은 1531MW, 총비용은 580억달러(약 79조원)로 추정했다.
Epoch AI의 추정치는 보도된 목표와 수량·기준 시점에서 차이가 난다. GB300과 B300을 같은 기준으로 집계했는지, GPU와 서버 단위를 어떻게 구분했는지는 공개된 자료만으로 확인하기 어렵다.
GPU 수량 외에 전력 인프라도 핵심 변수다. SpaceXAI 공식 업데이트는 미시시피주 사우스헤이븐 시설에 설치한 임시 이동식 터빈 69기를 2027년 7월까지 철거하고, 1.2GW 규모의 상설 발전소를 건설할 계획이라고 밝혔다.
미국 AP통신은 2026년 1월 xAI가 미시시피주 데이터센터에 200억달러(약 27조원)를 투입하고, 멤피스 일대 클러스터가 2GW의 컴퓨팅 전력을 확보할 것이라고 보도했다. 다만 이 보도 역시 GB300 66만개의 연말 배치 계획을 확인한 자료는 아니다.
GB300은 엔비디아의 Blackwell Ultra 기반 데이터센터용 플랫폼이다. GB300 NVL72는 72개의 Blackwell Ultra GPU와 36개의 Grace CPU를 결합한 시스템으로, 엔비디아는 Hopper 기반 플랫폼보다 AI 팩토리 처리량을 최대 50배 높일 수 있다고 설명한다.
이 수치는 플랫폼 설계상 성능을 가리키는 것으로, 실제 Colossus 2의 처리량과 일치한다고 볼 수는 없다. 냉각 방식과 전력 공급, 네트워크 구성, 장비 가동률에 따라 실제 성능은 달라질 수 있다.
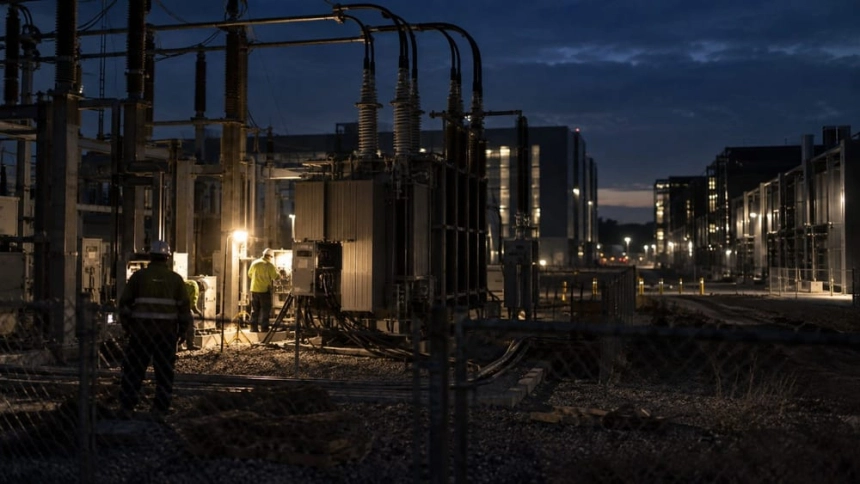
대규모 AI 데이터센터에서는 GPU 조달만으로 시설이 완성되지 않는다. 전력망 접속이나 자체 발전설비, 냉각장치, 전력 변환·배전 설비가 함께 구축돼야 GPU를 실제 연산에 투입할 수 있다.
AI 데이터센터의 전력 확보가 핵심 병목으로 떠오른 사례는 앞서 본지에서도 다뤘다. 당시에도 하드웨어 투입 규모와 별개로 전력 조달 방식이 비용 구조와 가동 시점을 좌우할 수 있다는 분석이 제시됐다.
스페이스X가 가스터빈 블레이드와 베인 생산을 준비하는 움직임도 AI 데이터센터 확장에 필요한 전력 확보와 연결돼 있다. 스페이스X의 터빈 부품 자체 주조 움직임은 전력 설비 공급망을 내부화하려는 사례로 보도된 바 있다.
국내 투자자와 반도체 업계가 주목할 대목은 GPU 공급량 자체보다 대규모 AI 인프라의 실제 가동 조건이다. 엔비디아의 GPU 수요가 커지더라도 데이터센터의 전력·냉각·네트워크 구축이 늦어지면 장비 설치 수량과 상업 가동 규모 사이에 차이가 생길 수 있다.
현재 공개된 내용에서 GB300 66만개는 확정된 배치 수치가 아니라 보도된 목표 수준이다. Colossus 2의 최종 GPU 구성과 가동 규모는 xAI의 시설 구축 진행 상황과 추가 공식 자료를 통해 확인될 예정이다.



댓글0
첫 댓글을 남겨 보세요.